- Google이 2026-04-22 Cloud Next 2026에서 TPU 8을 학습용 TPU 8t와 추론용 TPU 8i로 분할 발표 — TPU 10년 역사상 첫 분리 설계
- TPU 8t는 9,600칩/슈퍼팟·121 ExaFlops로 Ironwood 대비 ~3배, TPU 8i는 80% 우수한 perf-per-dollar로 Nvidia 추론 마진을 직접 겨냥
- Anthropic이 두 세대 모두의 앵커 고객 — 2027년 3.5GW 캐파를 Broadcom-Google이 공급하면서 같은 날 Nvidia Vera Rubin 협력도 동시 발표
9,600칩 한 팟. 121 ExaFlops가 한 클러스터에서 돌아갑니다. Google TPU 8이 2026-04-22 Cloud Next 2026 키노트에서 학습용 8t와 추론용 8i 두 칩으로 분할 공개되며, TPU 프로그램 10년 역사상 처음으로 학습/추론 실리콘이 분리됐습니다.
분할의 명분은 ‘agentic era’입니다. 모델 실험에서 영구적인 AI 에이전트 배포로 워크로드 축이 이동하면서, 단일 칩으로는 학습의 처리량과 추론의 단가를 동시에 잡기 어려워졌다는 것이 Google의 설명입니다. Thomas Kurian Google Cloud CEO는 이 분할을 “자연스러운 진화(a natural evolution)”라고 표현했습니다.

Google TPU 8 분할이 무엇이고 왜 지금인가
Sundar Pichai·Thomas Kurian·Amin Vahdat 라인업이 ‘agentic era’를 분할의 명분으로 선언했습니다. 이전 7세대 Ironwood까지는 단일 칩이 학습과 추론을 모두 담당했지만, 8세대부터는 코드명 Sunfish(8t)가 학습을, Zebrafish(8i)가 추론을 전담합니다.
두 칩의 공통점은 호스트 CPU(Axion ARM)와 공정(TSMC 2nm)입니다. 시스템 레벨에서 통합 최적화가 가능하다는 의미이며, Google이 발표한 GA(General Availability) 시점은 “2026년 후반”입니다.
핵심은 워크로드 분리가 단순 분기 마케팅이 아니라는 점입니다. 학습은 슈퍼팟 단위 처리량과 메모리 대역폭이, 추론은 칩당 단가와 지연 시간이 결정 변수이며, 이 두 KPI를 한 다이에 욱여넣는 한 어느 쪽도 최적화되지 않는다는 산업 합의가 8세대 분할로 굳어졌습니다.
TPU 8t (Sunfish): 학습 9,600칩 슈퍼팟의 숫자
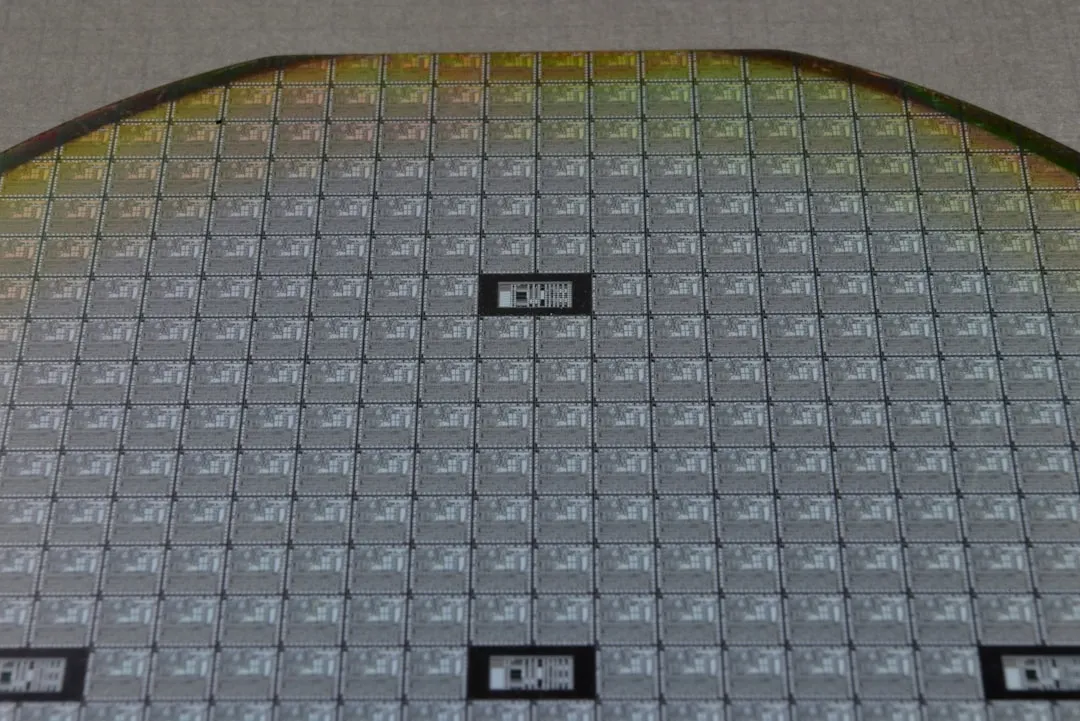
TPU 8t는 Broadcom이 설계했습니다. 단일 슈퍼팟이 9,600칩 + 2 PB 공유 HBM으로 묶여 121 ExaFlops를 내며, Ironwood 대비 약 3배 컴퓨트와 2x perf/watt를 실현합니다.
칩 단위로 보면 12.6 petaFLOPS(FP4), 216 GB HBM @ 6.5 TB/s 대역폭, 128 MB SRAM이 탑재됩니다. 칩 간 통신은 19.2 Tbps ICI로 두 배 확장됐고, Virgo Network 패브릭과 광 회선 스위칭(OCS)이 슈퍼팟 간 결합을 담당합니다.
같은 가격 대비 학습 성능은 2.8배가 명시됐고, goodput은 97%에 이릅니다. 여기서 핵심은 Google이 동일 비용에 거의 3배 가까운 학습 처리량을 약속한다는 점이며, 이는 Anthropic·DeepMind 같은 프런티어 모델 학습 사이클을 분기 단위로 짧힐 수 있다는 시사로 이어집니다.
TPU 8i (Zebrafish): 추론 80% 가성비의 실제 구조
TPU 8i는 MediaTek이 설계했습니다. 288 GB HBM @ 8.6 TB/s와 384 MB SRAM(이전 대비 3배)을 탑재해, 대형 LLM의 KV 캐시를 온칩에 그대로 호스팅하도록 했습니다.
네트워크 토폴로지는 Boardfly로 1,152 TPU를 직접 연결합니다. 통신 지연을 줄이기 위해 Collectives Acceleration Engine(CAE, 분산 통신 가속 엔진)이 탑재되어 on-chip 지연을 5배 단축한다는 게 Google의 설명입니다.
가성비 핵심 지표는 Ironwood 대비 80% 우수한 perf-per-dollar입니다. 동일 비용으로 약 2배의 고객 처리량(volume)을 받아낼 수 있다는 의미이며, 2x perf/watt까지 더하면 데이터센터 전력 단가까지 동시에 압축됩니다.
Anthropic 3.5GW 앵커와 Broadcom $46B 계약
Anthropic은 Stanford AI Index 2026에서 OpenAI를 추월한 직후, TPU 7(Ironwood)과 TPU 8 양쪽의 앵커 고객으로 등장했습니다. 2027년부터 Broadcom-Google 협업으로 3.5GW 신규 캐파가 공급되며, 2026년에는 약 100만 TPU 칩 규모의 1GW가 먼저 가동됩니다.
Mizuho 애널리스트 Vijay Rakesh는 Anthropic 관련 Broadcom AI 매출을 2026년 $21B, 2027년 $42B로 추정했습니다. Broadcom과 Google은 2031년까지 $46B AI 칩 공급 계약을 맺어둔 상태이며, Marvell·Intel·MediaTek까지 합치면 멀티 벤더 커스텀 실리콘 체제가 7년 단위로 락인됩니다.
Anthropic ARR 런레이트도 같은 흐름을 떠받칩니다. 2025년 말 약 $9B에서 $30B 돌파로 1년 새 약 3배 늘어, 3.5GW 컨디셔널 조항(‘continued commercial success’)이 깨질 위험은 단기적으로 낮다는 평가입니다.
Nvidia 동맹·Vera Rubin 그리고 ‘AI Hypercomputer’
같은 날 Google은 Nvidia와의 협업도 발표했습니다. Nvidia Vera Rubin 칩이 Google Cloud A5X 차세대 AI 인프라에 탑재된다는 것이며, GOOGL 주가는 발표 직후 1.5% 상승했습니다.
이 발표가 흥미로운 이유는, Google이 사내에서 이미 Nvidia GB300 시스템도 운영하고 있기 때문입니다. 한마디로 ‘AI Hypercomputer’는 TPU와 Nvidia GPU·Axion CPU를 한 인프라 레이어 안에서 함께 굴리는 멀티 실리콘 전략이며, 직접 경쟁이 아닌 워크로드별 최적 칩 라우팅으로 정의됐습니다.
여기에 같은 행사에서 GA로 풀린 TPU 7 Ironwood가 더해집니다. 칩당 4.6 PF, 192 GB HBM3e, 9,216칩 슈퍼팟이 42.5 ExaFlops를 끌어내며, Google Cloud Q4 매출이 +48% $17.7B로 점프하고 백로그는 $240B(YoY 2배)에 도달했습니다.
$250억 AI 칩 IPO, NVIDIA 57배 크기 Cerebras가 80% 독점을 깨뜨린다
Nvidia 마진 직격: 추론 비용이 흔드는 GPU 패권
Implicator.ai는 TPU 8i가 “추론 비용을 직접 공격(attacking inference cost specifically)”한다고 평가했습니다. Cerebras 같은 추론 전용 IPO 신예들과 같은 결로, 산업 축이 모델 학습 1회성에서 영구적인 AI 에이전트 배포로 이동하면서 추론 단가가 곧 GPU 마진의 운명을 결정한다는 인식이 굳어진 셈입니다.
Google이 공개한 TPU 출하 전망은 2026년 4.3M → 2027년 10M → 2028년 35M+ 칩입니다. 같은 추론량을 GPU에서 TPU로 옮길 때마다 Nvidia의 데이터센터 매출 풀이 줄어들며, 2028년 35M+ 칩 가동 시점이 GPU 패권의 첫 변곡점이 될 수 있다는 시나리오입니다.
업계 전반에서도 같은 패턴이 굳어지고 있습니다. AWS의 Trainium/Inferentia 분리 전략과 Marvell의 메모리 처리 유닛(MPU) 진입까지 더해지면, 하이퍼스케일러 커스텀 실리콘이 추론 단가를 끌어내리는 흐름이 굳어지며 Nvidia의 단일 GPU 표준은 학습 영역으로 점차 후퇴할 가능성이 높습니다.
1,503 Elo 왕좌 교체, Anthropic이 OpenAI 3년 독주 시대를 끝냈다
투자자·엔지니어가 다음에 봐야 할 3가지 체크포인트
첫째, TPU 8 GA 시점입니다. Google이 명시한 “2026년 후반” 일정이 실제 출하·과금 시작과 일치하는지, 그리고 첫 외부 벤치마크(MLPerf v6 Inference 등)에서 80% perf/$ 주장이 검증되는지가 시장 신뢰의 1차 관문입니다.
둘째, Google 2026년 capex 가이던스입니다. $175~$185B는 2025년 $91.4B 대비 약 2배이며, 어닝마다 정정될 가능성이 있어 매 분기 발표 직후의 capex 톤(상향/하향) 자체가 TPU 출하 전망 4.3M의 신호로 읽힙니다.
셋째, Anthropic 3.5GW 컨디셔널 조항입니다. SEC 문구상 “Anthropic의 지속적 상업 성공”에 캐파 소비가 묶여 있어, Anthropic ARR 성장률이 둔화되거나 Claude 매출이 흔들리는 분기에는 Broadcom-Google 동맹의 캐파 재배분 협상이 즉각 시작됩니다.
참고 자료
- Google Cloud Blog (2026-04-22) — TPU 8t·8i 분할 공식 발표 + Amin Vahdat 발언
- The Register (2026-04-22) — TPU 8t 칩당 12.6 PF·216 GB HBM 등 세부 스펙
- TheNextWeb (2026-04-22) — Sunfish/Zebrafish 코드명, Broadcom·MediaTek 분담, Anthropic 3.5GW
- Implicator.ai (2026-04-22) — Thomas Kurian “natural evolution” 인용, TPU 출하 전망
- Sherwood News (2026-04-22) — GOOGL 1.5%↑, Vera Rubin·A5X Nvidia 협업
- CNBC (2026-04-22) — Cloud Next 2026 키노트 종합
- Tom’s Hardware (2026-04-09) — Anthropic ARR $30B 돌파, 3.5GW 컨디셔널 조항
- Wccftech (2026-04-22) — Broadcom 학습/MediaTek 추론 분담 구조
- Sundar Pichai @ Cloud Next 2026 (2026-04-22) — Google Cloud 백로그 $240B·Q4 +48%

Jugger | JuggerInsight 운영자 · 백엔드 엔지니어
2021년 6월부터 솔루션 서비스 소프트웨어 도메인에서 백엔드 엔지니어로 재직 중입니다. 시스템 설계·API 구현·운영 환경의 실무 시각을 AI·IT·클라우드 인프라 관련 글에 그대로 반영합니다.
블록체인·매크로 경제 분야는 직접적 직업 경험은 없으나, SEC 공시·백서·기관 리포트·정부 통계 등 1차 자료 인용을 기반으로 분석합니다. 추정과 사실을 본문에서 명확히 구분하고, 검증되지 않은 정보는 게재하지 않는 것을 원칙으로 합니다. 모든 글의 1차 출처 링크는 본문 하단 References에 전수 공개합니다.
콘텐츠 초안 단계에서 AI 모델을 보조 도구로 활용하나, 모든 글은 운영자가 검토·수정·검증한 뒤 발행합니다. 오류 발견 시 본문에 정정 표시를 남깁니다.
문의: jjunggulee@gmail.com